素材整理:先建立可追溯结构
按项目、日期、机位和授权记录整理素材,给后续辅助粗剪留下清晰上下文。
自动化适合减少机械整理,不适合替作者承担事实、版权和叙事判断。页面把每一步都放在可回退、可检查的时间线里。
先把“辅助”说清楚,才能正确理解后面的每个自动步骤。
按项目、日期、机位和授权记录整理素材,给后续辅助粗剪留下清晰上下文。
根据镜头长度、语音段落和重复片段生成候选顺序,再由作者逐段确认叙事是否成立。
自动转写用于形成初稿,随后检查人名、地名、专业词、断句与时间码。
从重复信息、空镜长度和声音桥入手缩短内容,而不是机械删除所有停顿。
第一遍看叙事连续,第二遍查字幕与公开信息,第三遍核对音乐、素材和授权记录。
根据发布场景选择分辨率和码率,同时保留高质量归档版本、字幕文本与版本说明。
原文件只读保存,编辑在工作副本上进行。
给采访、场景和镜头组写清拍摄用途与公开范围。
涉及个人信息或未经确认内容的素材先隔离,不进入自动批量处理。
候选顺序可以节省筛选时间,但不能证明叙事已经成立。
镜头按拍摄顺序排列,重复、失焦和空白片段混在一起,作者需要先建立基本选择范围。
系统可以按语音段落、镜头长度和重复度提供建议,但每一个保留与删除都需要作者回看上下文。
自动转写最适合做初稿。专名、地名、数字、行业术语和否定词必须回听,无法确认时先标记,不用猜测补齐。
先删重复信息,再调空镜长度和声音桥,不机械清除所有停顿。
步骤之间需要给观众读字和理解动作的时间,过快会降低可用性。
保留合适呼吸与停顿,人物表达才不会被剪成只有结论。
动作、地点和环境声可以共同形成节奏,不必每一秒都有台词。
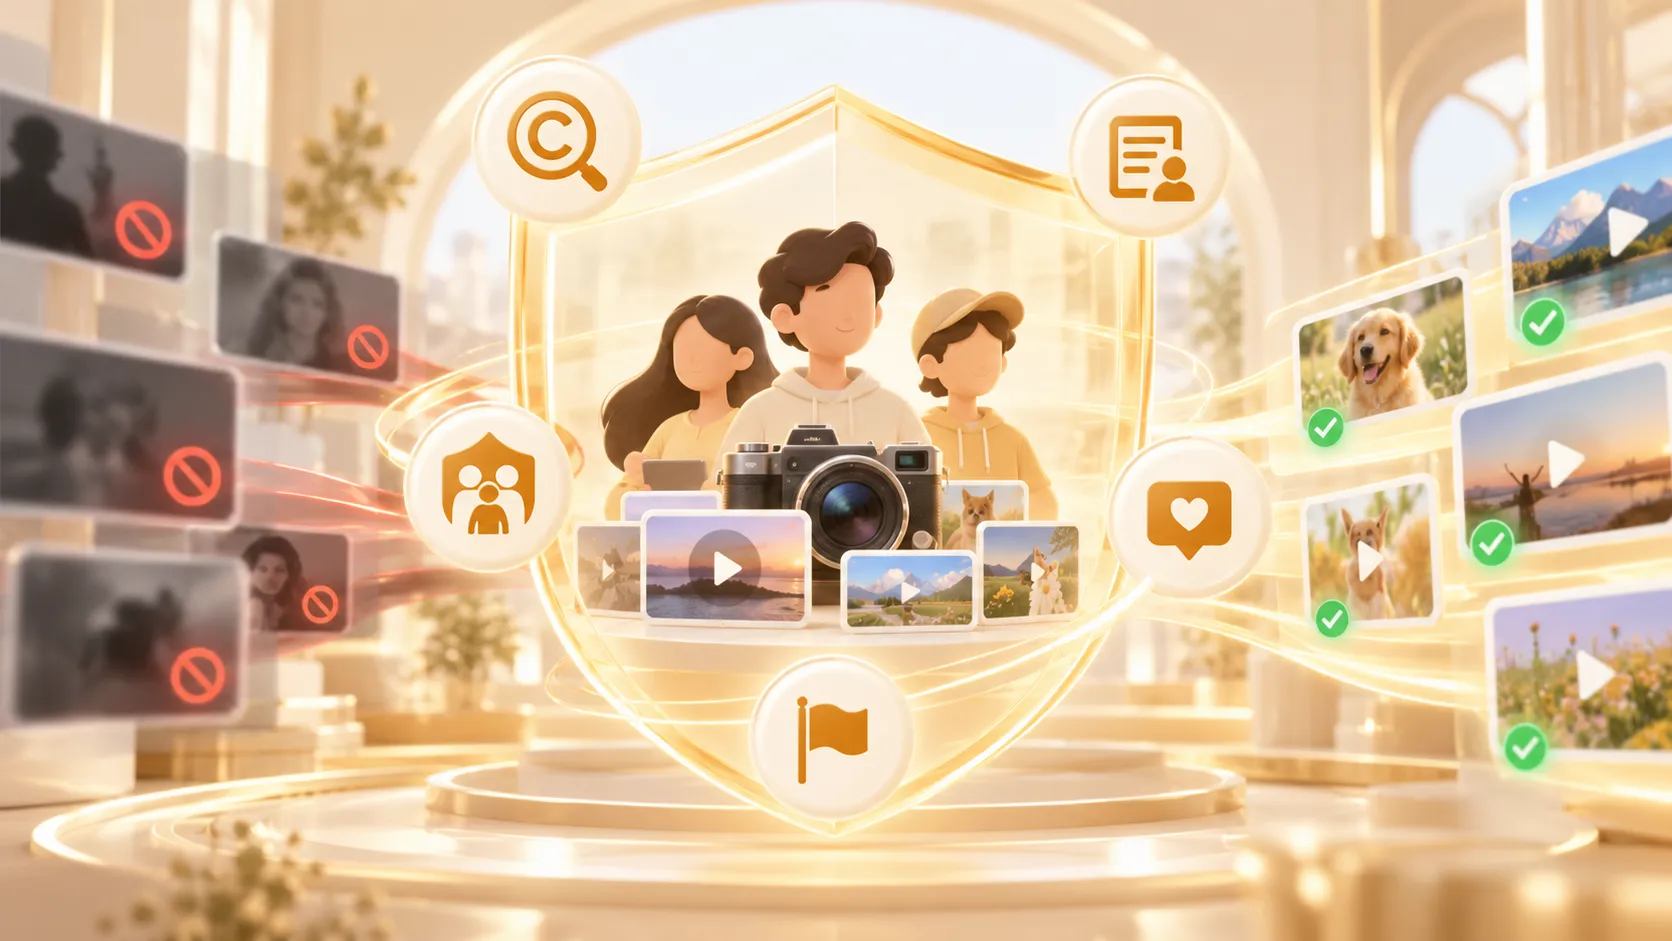
交付前至少做三遍:第一遍只看叙事是否连续;第二遍核对字幕、数字和公开信息;第三遍检查音乐、图片、片段、授权范围和可能涉及的个人隐私。
不同发布平台规格会变化,这里只提供通用交付检查,不伪造固定审核结论。
根据当前平台要求导出并检查播放。
保留更高质量版本,方便后续修改。
单独保存复核后的字幕与时间码。
记录修改日期、素材变化和交付用途。
包含住址、证件、私人聊天、未公开行程、医疗隐私或未成年人隐私的素材不应进入自动处理流程。工具能力不能替代内容收集前的合法性和必要性判断。
查看隐私边界对照的目的不是证明自动结果“更好”,而是帮助作者识别哪些变化真正改善了可读性。
镜头更短、字幕更齐,但人物回答中的限定条件被压缩得过多。
恢复关键停顿和条件句,减少两个装饰性转场,让信息更准确、节奏仍然紧凑。
重点回答自动能力边界、字幕复核、隐私与导出问题。
不会这样承诺。AI剪辑室把自动能力定位为整理、候选粗剪、字幕初稿和节奏辅助,所有关键步骤都保留人工确认点。人物表达、事实、版权、字幕专名与最终叙事仍需要作者逐项复核。
当前页面中的收藏、观看记录和部分互动状态只保存在浏览器本机 localStorage,用于演示个人整理体验。代码对存储失败做了容错,不会因为浏览器限制而阻断正文浏览;隐私页也会说明这些本机数据的用途。
只有公开可核对的信息才能写入事实部分。存在转述或争议时,页面会把原始说法、来源类别、证据缺口、公开回应和当前核验状态分开呈现,并使用“待核实、已回应、已澄清、信息不足、仅为公开讨论”等状态。
不能。本站不接受住址、手机号、证件号、车牌、精确定位、私人聊天、非公开行程、医疗隐私、未成年人隐私或其他可能造成现实伤害的个人信息。内容讨论应回到公开作品、公开声明和可验证来源。
拍摄环境、设备、光线、声音和发布场景差异很大,一套固定数值很难保证结果。教程更重视观察顺序与判断依据,例如先看高光是否溢出、先听环境底噪,再决定是否调整参数,让方法可以迁移到不同场景。
还没有收藏内容。